Caso práctico: filtros OData sobre un Analytic Model de Datasphere
Paso a paso para filtrar un Analytic Model por OData: dimensión frente a medida agregada, startswith y contains, top N y $metadata, con datos de ejemplo.
Índice del artículo
Cuando un Analytic Model de SAP Datasphere sale hacia algo que no es SAP Analytics Cloud (una app propia, un script de Python, Power BI), la puerta suele ser la OData Consumption API. Este año SAP le ha añadido dos cosas que cambian mucho lo que se puede pedir sin descargar todo: filtrar por el valor agregado de una medida y filtrar texto por coincidencia parcial (startswith, endswith, contains). En este caso práctico las probamos con 24 ventas de ejemplo y sin salir del editor del modelo, y vemos dos trampas: el mismo filtro de medida da resultados distintos según el nivel de agregación que pidas, y al combinarlo con un filtro de dimensión el resultado no es el que esperarías.
Qué vamos a construir
Un modelo de ventas de una distribuidora de alimentación. Al acabar tendrás:
- Una tabla local
T_FOOD_SALEScargada desde un CSV, una vista factV_FOOD_SALESy un Analytic ModelAM_FOOD_SALES. - Una batería de peticiones OData lanzadas desde el diálogo Generate OData Request del modelo, cada una con su resultado esperado: filtro de dimensión, filtro de medida a dos niveles de agregación, filtros parciales de texto, top N y metadatos.
Todos los nombres técnicos son de ejemplo: usa los de tu convención.
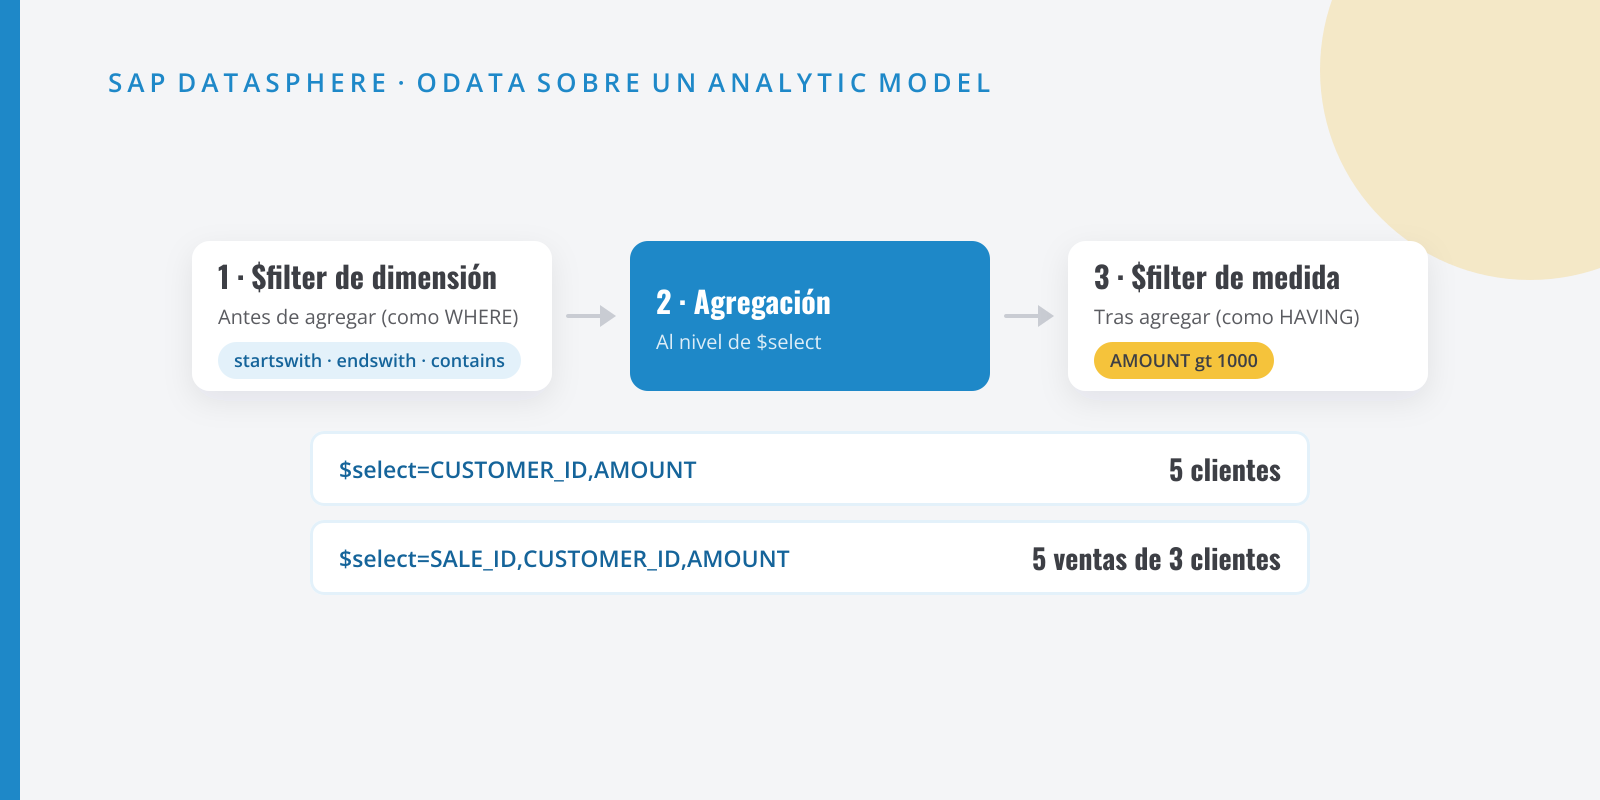
La idea clave, que SAP deja escrita en la documentación de la API: los filtros sobre dimensiones se aplican antes de generar el cubo, y los filtros sobre medidas agregadas, después. Si vienes de SQL, es la diferencia entre WHERE y HAVING. SAP añade que el filtro de medida es más costoso en rendimiento, precisamente por eso. Ojo, porque en mi prueba la combinación de los dos no se comportó como sugiere esa frase (lo vemos en el paso 7).
Paso a paso
Paso:Sube los datos de ejemplo
Descarga ventas.csv: 24 ventas ficticias de julio a septiembre de 2026, de cinco clientes y seis productos, que suman 17.240. He dejado los nombres de cliente y producto en la propia tabla para que el caso necesite un solo CSV; en un modelo real irían en dimensiones.
Cliente Nombre Región Importe C001 Supermercados Norte NOR 3.740 C002 Hosteleria Centro CEN 4.660 C003 Tienda Sur SUR 1.540 C004 Cash Levante EST 6.000 C005 Cafeteria Norte NOR 1.300 Los códigos de producto tienen un patrón a propósito: empiezan por
CAF,TEoACEsegún la familia, y los de café en formato de 1 kg acaban en1K.En el Data Builder, abre el menú de importación y elige Import CSV File para crear
T_FOOD_SALES. En el editor de importación, revisa en Details el tipo de cada columna. En mi prueba Datasphere los detectó bien a la primera:SALE_IDyQUANTITYcomo Integer,AMOUNTcomo Number ySALE_DATEcomo Date. SeleccionaSALE_ID, marca Set as Key en Details y despliega.Paso:Crea la vista fact
Crea una SQL View
V_FOOD_SALES:V_FOOD_SALES.sql SELECT "SALE_ID", "SALE_DATE", "CUSTOMER_ID", "CUSTOMER_NAME","REGION_ID", "PRODUCT_ID", "PRODUCT_NAME","QUANTITY", "AMOUNT"FROM "T_FOOD_SALES"Ponle Semantic Usage = Fact, valida el SQL para que aparezcan los atributos y pasa
AMOUNTyQUANTITYa Measures (arrastrándolas o con el menú ··· del atributo, Change to Measure). En el mismo menú deSALE_ID, Set as Key. El resto quedan como atributos. Despliega.Paso:Crea y despliega el Analytic Model
Crea el Analytic Model
AM_FOOD_SALESarrastrandoV_FOOD_SALESal lienzo. En el diálogo de alta deja marcadas Add all attributes y Add all measures, y despliega: la API solo sirve modelos desplegados.En la pestaña Preview, sin nada en filas, debes ver el total: 17.240 de
AMOUNT(y 1.385 deQUANTITY). DesmarcaQUANTITY, ponCUSTOMER_IDen filas y tendrás la tabla de clientes del paso 1. Si no cuadra, revisa los tipos de la importación antes de seguir.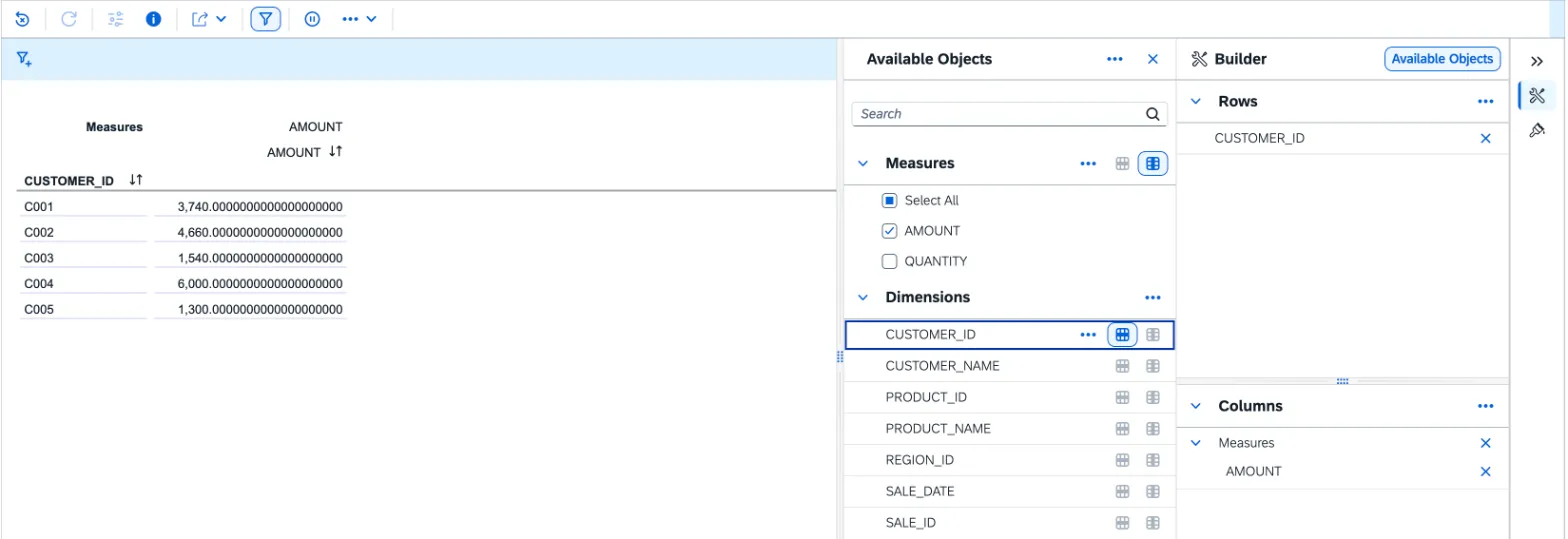
Preview de AM_FOOD_SALES por cliente: los mismos importes que la tabla del paso 1. Paso:Abre Generate OData Request y lanza la primera petición
En el editor de
AM_FOOD_SALES(modo Model), pulsa Generate OData Request en la barra de herramientas. Deja Request = Data. En Query Parameters, el desplegable Name ofrece$filter,$orderby,$select,$skip,$topysap-language; cada uno que eliges se añade como una fila y su Value es texto libre. Añade$selectconCUSTOMER_ID,AMOUNTy pulsa Preview: el diálogo muestra la respuesta JSON, limitada a 100 registros, más que suficiente aquí. Con Configure vuelves a los parámetros.La URL que genera tiene esta forma:
Petición base https://<tenant>/api/v1/datasphere/consumption/analytical/<espacio>/AM_FOOD_SALES/AM_FOOD_SALES?$select=CUSTOMER_ID,AMOUNTEl
$selectno solo elige columnas: en un Analytic Model decide el nivel de agregación. Con una medida y un atributo obtienes la medida agregada por cada valor del atributo; con soloAMOUNT, el total. Debes ver los cinco clientes con sus importes.Paso:Filtra por una dimensión
Añade el parámetro
$filterconREGION_ID eq 'NOR', manteniendo$select=CUSTOMER_ID,AMOUNT:Filtro de dimensión ?$select=CUSTOMER_ID,AMOUNT&$filter=REGION_ID eq 'NOR'Resultado: C001 con 3.740 y C005 con 1.300. El filtro elimina filas antes de agregar, como un
WHERE.Las comillas simples son obligatorias en los valores de texto. Sin ellas (
REGION_ID eq NOR) la API interpretaNORcomo el nombre de una propiedad y respondeSERVICE_BAD_REQUEST: Property ‘NOR’ does not exist in type ‘InaApplicationService.AM_FOOD_SALES’.Paso:Filtra por una medida a dos niveles de agregación
Ahora la novedad. Cambia el filtro a
AMOUNT gt 1000:Filtro de medida por cliente ?$select=CUSTOMER_ID,AMOUNT&$filter=AMOUNT gt 1000Resultado: los cinco clientes, con sus totales completos, porque todos suman más de 1.000. El filtro se evalúa sobre el importe ya agregado por cliente: si se evaluara venta a venta, C003 y C005 desaparecerían. Si subes el umbral a
AMOUNT gt 3000, quedan tres: C001 (3.740), C002 (4.660) y C004 (6.000). La respuesta viene ordenada por cliente, no por importe.Vuelve a
AMOUNT gt 1000y añadeSALE_IDal$select:El mismo filtro, por venta ?$select=SALE_ID,CUSTOMER_ID,AMOUNT&$filter=AMOUNT gt 1000Resultado: cinco ventas de solo tres clientes: 1001 y 1002 de C001 (1.200 cada una), 1006 de C002 (1.800), y 1015 (2.000) y 1016 (1.800) de C004. C003 y C005 desaparecen: suman más de 1.000, pero ninguna de sus ventas lo supera.
Es la misma condición y una pregunta de negocio distinta: “clientes que facturan más de 1.000” frente a “ventas de más de 1.000”. En una integración, esto es lo primero que validaría con quien consume los datos.
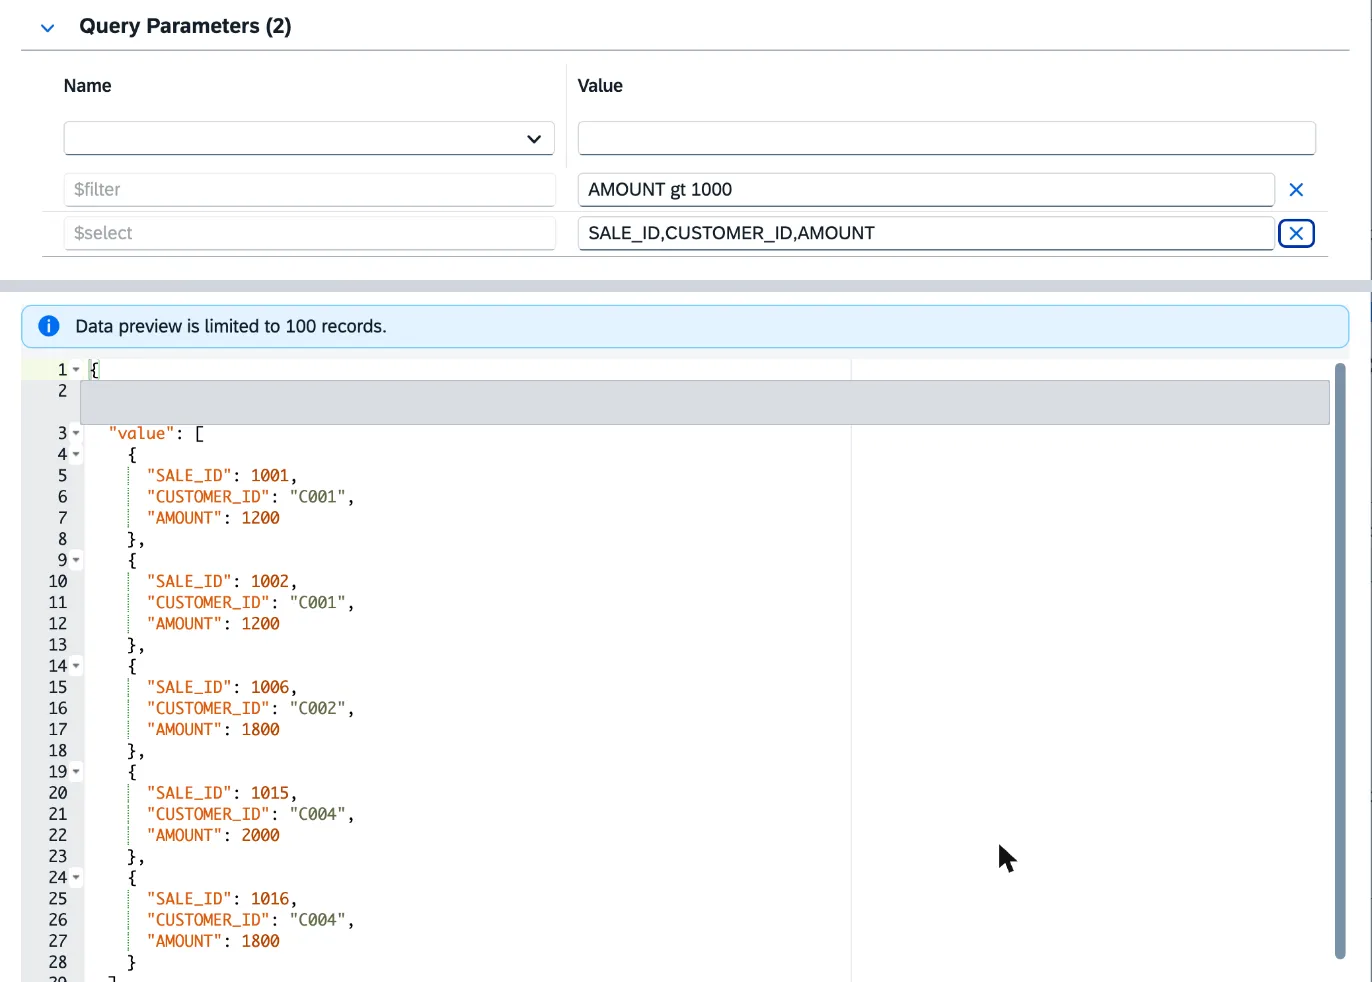
Arriba, los parámetros; abajo, el Preview: cinco ventas de tres clientes. He tapado la línea con la URL del tenant. Paso:Combina filtros parciales de texto y de medida
Los filtros parciales funcionan sobre atributos de texto. Pide las ventas de café por cliente y quédate con los clientes que superan 1.000 en café:
Café por cliente, más de 1.000 ?$select=CUSTOMER_ID,AMOUNT&$filter=startswith(PRODUCT_ID,'CAF') and AMOUNT gt 1000Yo esperaba cuatro clientes: C002 (3.500), C004 (2.800), C001 (1.800) y C005 (1.090), con C003 fuera por sus 360 de café. No es lo que devuelve. Salen los cinco, y C003 aparece con 360:
Cliente Importe devuelto (solo café) Total del cliente (todo) C001 1.800 3.740 C002 3.500 4.660 C003 360 1.540 C004 2.800 6.000 C005 1.090 1.300 El importe devuelto sí es el de café, pero la condición
AMOUNT gt 1000se ha comparado con el total del cliente de todos los productos. Lo confirmé subiendo el umbral aAMOUNT gt 5000: devuelve solo C004, con 2.800, porque es el único cliente que pasa de 5.000 en total. Coneqpasa lo mismo:PRODUCT_ID eq 'CAF-MOL-1K' and AMOUNT gt 1000devuelve cuatro clientes, incluidos C003 (360) y C005 (240).Funciona como esperas si la dimensión filtrada también está en el
$select. Con$select=CUSTOMER_ID,PRODUCT_ID,AMOUNTy el mismo filtro sobreCAF-MOL-1Ksalen solo C001 (1.200) y C004 (1.800). En el paso 5 no se notaba porque cada cliente tiene una sola región: el total por cliente es el mismo con filtro y sin él.Esto choca con lo que dice SAP (la dimensión se filtra antes de generar el cubo), así que puede ser un fallo que corrijan. Mientras tanto, en una integración: si combinas un filtro de dimensión con uno de medida, pon esa dimensión en el
$selecty agrega tú en el cliente si la necesitas a un nivel superior.Prueba también las otras dos funciones, sin filtro de medida, con
$select=PRODUCT_ID,AMOUNT,PRODUCT_NAME,AMOUNToCUSTOMER_NAME,AMOUNT:$filterResultado endswith(PRODUCT_ID,'1K')CAF-GRA-1K 3.750 y CAF-MOL-1K 3.600 contains(PRODUCT_NAME,'grano')Cafe en grano 1 kg 3.750 contains(CUSTOMER_NAME,'Norte')Cafeteria Norte 1.300 y Supermercados Norte 3.740 La documentación no dice si estas funciones distinguen mayúsculas y minúsculas. En mi prueba no las distinguen:
contains(CUSTOMER_NAME,'norte')devuelve los mismos dos clientes ystartswith(PRODUCT_ID,'caf'), los tres productos de café.Paso:Ordena y limita: el top 3 de clientes
Top 3 clientes por importe ?$select=CUSTOMER_ID,AMOUNT&$orderby=AMOUNT desc&$top=3Resultado: C004 (6.000), C002 (4.660) y C001 (3.740). Añadiendo
$skip=3con el mismo orden obtienes los dos siguientes: C003 (1.540) y C005 (1.300). Lo que no funciona en un Analytic Model es$count=true: SAP indica que no se admite en las peticiones analíticas, el desplegable del diálogo ni siquiera lo ofrece y los metadatos lo declaran conCountable = false.Paso:Consulta los metadatos
En el mismo diálogo, cambia Request a Metadata y pulsa Preview. Obtienes la definición XML del servicio: un
EntityTypecon una propiedad por medida y atributo, cada una con su tipo (AMOUNTcomoEdm.Decimal,QUANTITYcomoEdm.Int64,SALE_DATEcomoEdm.Date…), y anotaciones de capacidades como la de$count. Desde la 2026.10, SAP añade también información sobre la definición de variables y filtros; este modelo no tiene ninguna, así que aquí no aparece.Úsalo para comprobar los nombres exactos de las propiedades antes de escribir un
$filter. Aquí coinciden con las columnas de la vista, pero cuando el modelo trae dimensiones asociadas con textos, el nombre de la columna de texto lo genera Datasphere y puede cambiar al redesplegar. Lo vimos en el caso de textos multilingües.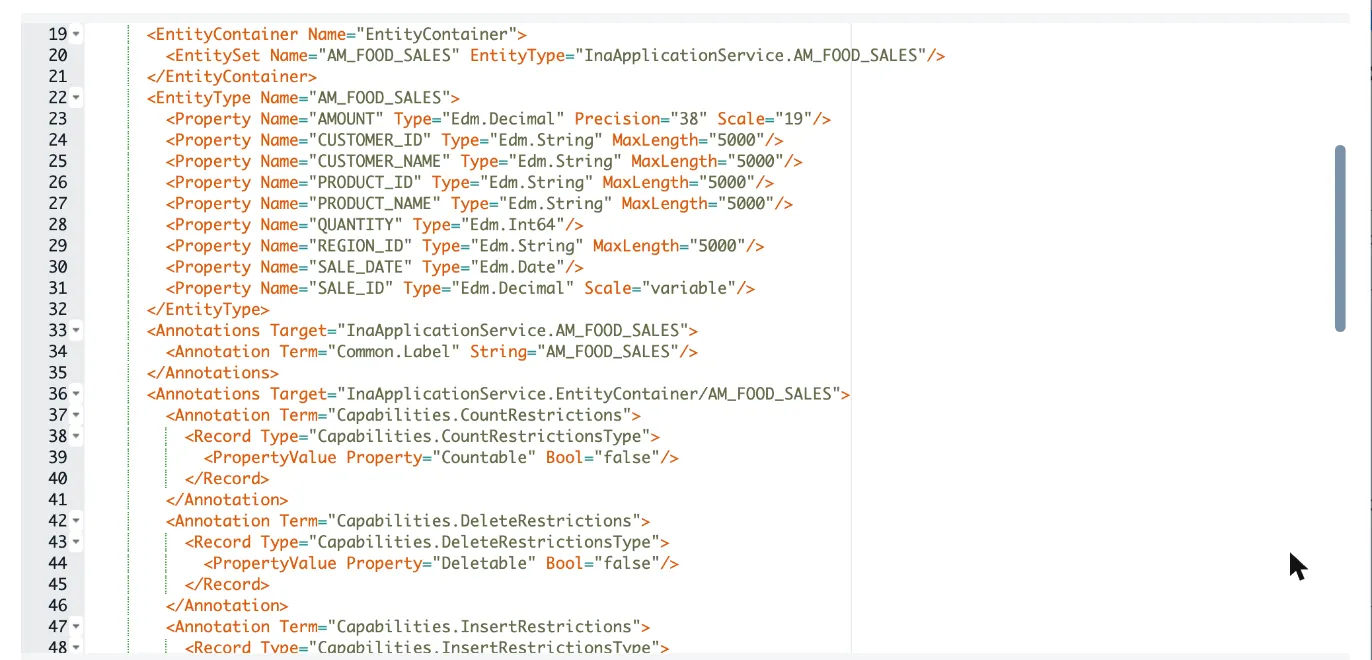
Metadatos de AM_FOOD_SALES: nombres y tipos de las propiedades, y Countable = false.
Validación
Esto es lo que devolvió cada petición en mi tenant con los datos de ejemplo:
Petición ($select · $filter / otros) |
Filas | Resultado |
|---|---|---|
AMOUNT |
1 | 17.240 |
CUSTOMER_ID,AMOUNT |
5 | Tabla del paso 1 |
CUSTOMER_ID,AMOUNT · REGION_ID eq 'NOR' |
2 | C001 3.740 · C005 1.300 |
CUSTOMER_ID,AMOUNT · AMOUNT gt 1000 |
5 | Los cinco clientes |
CUSTOMER_ID,AMOUNT · AMOUNT gt 3000 |
3 | C001 · C002 · C004 |
SALE_ID,CUSTOMER_ID,AMOUNT · AMOUNT gt 1000 |
5 | Ventas 1001, 1002, 1006, 1015, 1016 |
CUSTOMER_ID,AMOUNT · startswith(PRODUCT_ID,'CAF') and AMOUNT gt 1000 |
5 | Los cinco, con el importe de café |
CUSTOMER_ID,PRODUCT_ID,AMOUNT · PRODUCT_ID eq 'CAF-MOL-1K' and AMOUNT gt 1000 |
2 | C001 1.200 · C004 1.800 |
CUSTOMER_ID,AMOUNT · $orderby=AMOUNT desc&$top=3 |
3 | C004 · C002 · C001 |
Para cruzar resultados, la pestaña Preview del modelo admite filtros (Add Filter) y, desde la 2026.20, exportar a Excel o CSV, salvo que la exportación esté protegida en las propiedades del modelo. Un detalle si después integras: la misma página de SAP dice en un apartado que las peticiones devuelven por defecto los 10 primeros resultados y, en el de datos analíticos, que se devuelven hasta 50.000 registros. No dependas del valor por defecto: pide siempre $top y sigue el @odata.nextLink para paginar.
Errores habituales
| Síntoma | Causa | Solución |
|---|---|---|
| El filtro de medida “no filtra” lo que esperabas | Se evalúa sobre el valor agregado al nivel del $select |
Decide primero el nivel (cliente, venta…) y ajusta el $select |
| Combinas un filtro de dimensión y uno de medida y salen filas que no cumplen la condición | La condición de medida se comparó con el total sin el filtro de dimensión (comportamiento observado en el paso 7) | Pon en el $select la dimensión que filtras |
Error Property 'NOR' does not exist |
Valor de texto sin comillas simples: la API lo toma por un nombre de propiedad | Escribe REGION_ID eq 'NOR' |
Error al usar $count=true |
No se admite en peticiones analíticas | Cuenta en el cliente o usa una vista expuesta con petición relacional |
startswith, contains o gt fallan en otro modelo |
Alguna fuente del linaje no está replicada en Datasphere: entonces $filter solo admite eq, and, or y paréntesis, y no hay $count, $top ni $skip |
Replica la fuente o filtra en el origen; revisa el linaje con Impact and Lineage Analysis |
Error con un valor como O'Brien |
La API no admite valores con comillas simples | Filtra por el código, no por el texto |
| La URL copiada da error de autenticación en el navegador | Tenant en una formation de BDC: hace falta OAuth explícito | Usa el Preview del diálogo o un cliente OAuth |
Property ... does not exist |
Nombre de propiedad distinto del que crees (p. ej., columnas de texto) | Consulta el nombre real con Request = Metadata |
Cierre
Mi criterio después de probarlo: el filtro de medida es la mejora más útil de la API en mucho tiempo, porque evita descargar todo para quedarte con “los clientes que superan X”. Pero úsalo con cabeza. Filtra por dimensiones todo lo que puedas, porque es más barato. Deja el filtro de medida para la pregunta que de verdad lo necesita y deja escrito en la especificación de la integración a qué nivel se agrega. Y si lo combinas con un filtro de dimensión, comprueba el resultado con datos que conozcas: en mi prueba, sin esa dimensión en el $select, devolvió filas que no cumplían la condición. Y si el consumidor va a hacer muchas llamadas, ten en cuenta el límite de SAP: unas 300 peticiones por usuario y minuto, con respuesta HTTP 429 al superarlo.
El siguiente paso natural es repetir estas peticiones desde un cliente externo con un cliente OAuth de usuario técnico. Ojo con la seguridad: con ese tipo de cliente, las Data Access Controls se evalúan con el ID de usuario asociado al cliente OAuth, así que dale a ese ID los permisos que correspondan.